Veri Bilimi Notları 6: Çoklu lineer regresyon
Birden fazla bağımsız değişkenle çalışmak: kukla değişkenler, P değeri ve geriye doğru eleme.
İçindekiler
Bu seride bulunan önceki yazılarım:
- Veri Bilimi Notları 1, Makine öğrenmesine giriş
- Veri Bilimi Notları 2, Makine öğrenmesi ve Python
- Veri Bilimi Notları 3, Veri önişleme
- Veri Bilimi Notları 4, Özellik ölçeklendirme
- Veri Bilimi Notları 5, Lineer regresyon
Merhabalar. Bir önceki veribilimi yazımda sizlere lineer regresyondan bahsetmiştim. Aslında bu yazımda da lineer regresyondan bahsedeceğim fakat birkaç fark olacak. Önceki yazılarımda olduğu gibi yine yapacağım ilk şey işin teorik kısmını anlatıp sonra Python uygulamasına geçmek. Umarım sizler için faydalı olur.
Çoklu Lineer Regresyon Nedir?
Çoklu lineer regresyonu anlamak için öncelikle lineer regresyonu anlamak gerekiyor. Bundan dolayı bir önceki yazımda kullandığım verisetine bakalım.
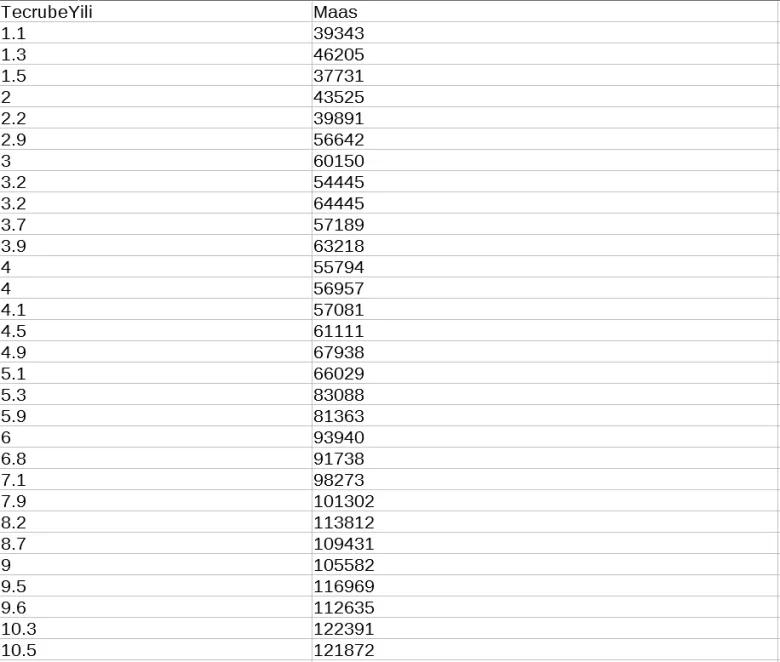
Üstteki verisetine baktığımızda iki adet değişken görmekteyiz. Bunlardan birisi bağımlı birisi bağımsız değişken. Biz de bunların arasındaki bağıntıyı lineer regresyon yöntemiyle bulup model oluşturduktan sonra test yapmıştık. Fakat lineer regresyon dediğimiz şey birden fazla değişken içerirse nasıl bir şey yaparız? İşte burada çoklu lineer regresyon dediğimiz şey ortaya çıkıyor. Çoklu lineer regresyon birden fazla değişkene bağlı olan ve bağımlı değişkeni doğrusal bir artış gösteren verisetlerindeki değişkenlerin arasındaki bağıntıyı bulmaya yarayan yöntemdir.
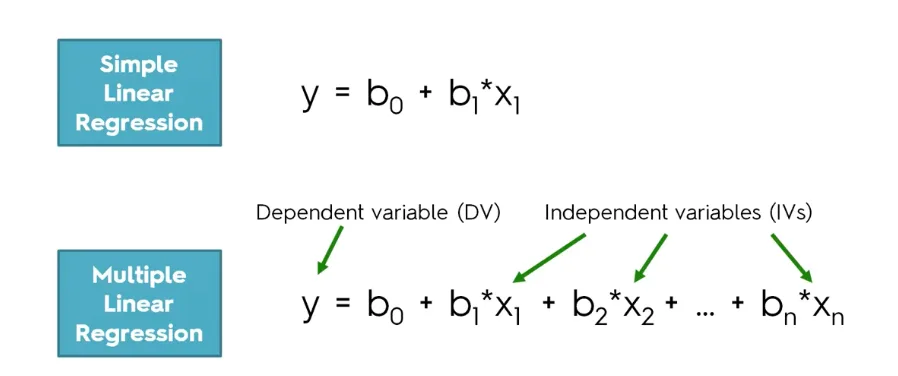
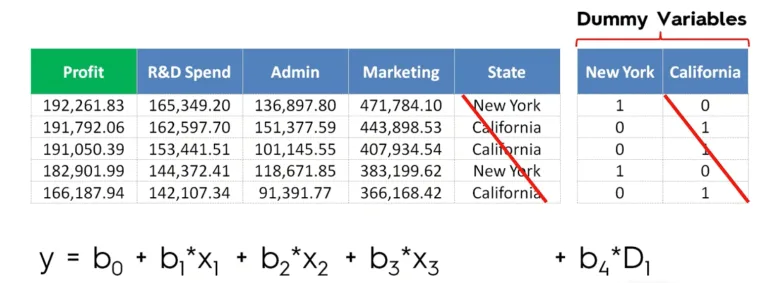
Çoklu lineer regresyonda her bağımsız değişkenin bağımlı değişkene etkime derecesi birbirinden farklıdır. Bundan dolayı basit lineer regresyondaki denkleme ek olarak her değişkenin katsayısı aynı olmak zorunda değildir. Diğer yandan bu yazı serisinin 3. yazısında kategorik niteliklerin nümerik hale getirilmesi konusunu anlatmıştım. O yazıda kategorik nitelikleri olan değişkende birden fazla çeşit veri olduğu için (Hatay, İstanbul, Karaman gibi), her birine bir numara vermiştik fakat iki çeşit beriden oluşan kategorik değişkenlerde boolean (yani 0 ve 1) mantığını kullanabiliriz. İstatistik biliminde kategorik verilerin yerine bu şekilde kullandığımız sanal verilere “dummy variables” denir.
P Değeri Nedir? Ne işe yarar?
P değeri, bizim hipotezlerimizin doğru olup olmadığını belirlememize yardımcı olan istatistiksel bir ölçüdür. P değerleri, deney sonuçlarının gözlemlenen olaylar için normal değerler aralığında olup olmadığını belirlemek için kullanılır. Genellikle, bir veri setinin P değeri belli bir önceden belirlenmiş miktarın altındaysa (örneğin, 0.05 gibi), bilim insanları deneylerinin “boş hipotezini” reddedeceklerdir, başka bir deyişle, hipotezi ekarte edeceklerdir. Deney değişkenlerinin sonuçlar üzerinde anlamlı bir etkisinin olmadığı anlaşılmış olacaktır diğer bir deyişle. Eğer bu meseleyi daha detaylı anlamak istiyorsanız aşağıdaki videoyu izlemeniz oldukça yararlı olacaktır.
İşte biz de değişkenlerin çoklu lineer regresyon içerisindek P değerlerini bulup, belirli bir eşiğin üstündeki P değerine sahip olan değişkenleri veri setinden çıkartacağız. Böylece modelimizi optimize edeceğiz.
Çoklu Lineer Regresyon Modeli Oluşturmak
Çoklu lineer regresyon modeli oluştururken dikkat etmemiz gereken şeylerin sayısı basit lineer regresyondan oldukça fazladır çünkü hangi değişkenin önemli olup olmadığını anlamak çoklu lineer regresyon için çok temel ve çok hassas bir noktadır. Bağımlı değişkene oldukça etkiyen bir değişkeni verisetinden kaldırdığımız zaman oluşacak hatalar, yahut gereksiz bir değişkeni verisetinden atmadığımız zaman kaybedeceğimiz verim bize büyük zararlar olarak dönecektir. Bundan dolayı bu noktayı çok dikkatli bir şekilde aşmamız gerekmekte. İşte bundan dolayı da istatistik bilimiyle uğraşan insanlar bizler için çeşitli yöntemler belirlemişler. Bu yönetemleri sıralamak gerekirse:
- Hepsi bir arada, Geriye doğru eleme (eliminasyon), İleri doğru eleme, Çok yönlü eleme, Puan Karşılaştırması
Geriye Doğru Eleme
Geriye doğru eleme yöntemi tüm değişkenleri içeren bir modelden, fazlalıklarını atarak daha verimli daha küçük bir model oluşturma içeren algoritmadır. İşleyişi ise şöyledir:
- Değişkenlerin modelde kalması için önem değeri belirlenir ( Significance Level, SL = 0,05 gibi)., Modelle alakasız değişkenler modelden çıkarılır., En yüksek P değerine sahip değişkeni bul. Eğer önem değerinden yüksekse (P>SL) bir sonraki adıma ilerle. Eğer düşükse modelin geriye doğru eleme algoritmasını tamamlamıştır., P değeri önem değerinden yüksek değişkeni modelden çıkart ve 3. adıma dön.
İleri Doğru Eleme
İleri doğru eliminasyon (eleme) yöntemi geriye doğru eliminasyon yönteminden farklı olarak hiçbir bağımsız değişken içermeyen bir model olarak başlar yolculuğuna. Sonrasında ise hipoteze en yararlı olduğu tahmin edilen değişkenleri alarak kendisini daha büyük bir model haline getirir. İşleyişi ise şöyledir:
- Modele giriş için bir önem değeri belirlenir. (Örneğin SL=0,05), Bütün bağımsız değişkenler ve bağımlı değişkenle ayrı ayrı ikişerli modeller oluşturulur. En küçük P değerine sahip değişken seçilir., Seçilen değişken modele eklenir. Bundan sonrasında ise belirlenen önem değerinden düşük olmakla beraber yine en küçük P değerine sahip değişken modele eklenir., Bu işlem seçilen yeni değişkenin P değerinin önem değerinden fazla olmasına kadar devam eder. En küçük P değerine sahip yeni değişkenin P değerinin önem değerinden fazla olduğunu gördüğümüzde daha önce eklediğimiz değişkenlerin model için yeterli olduğunu anlamalıyız.
Bu yazıda sizleri daha fazla yöntemle karmaşaya boğmak istemiyorum. Çok yönlü eleme yöntemi hakkında bilgi sahibi olmak isterseniz “bidirectional elimination” anahtar kelimesiyle araştırma yapabilirsiniz.
Python Uygulaması
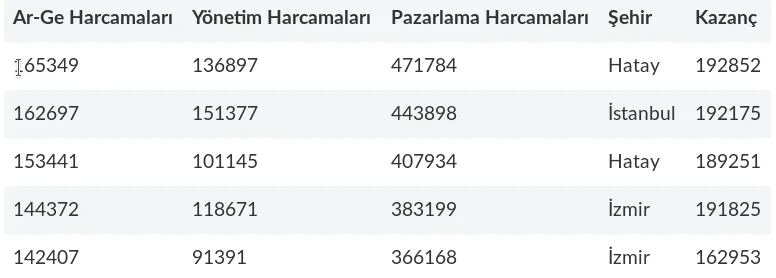
Yapacağımız uygulamada Türkiye’nin bazı şehirlerinde yer alan bazı yazılım şirketlerinin ar-ge harcamalarını, yönetim harcamalarını, pazarlama harcamalarını, hangi şehirde bulunduklarını ve kazançlarını biliyoruz. Bizim yapmak istediğimiz şey ise bu değişkenlerden hangilerinin kazanç ile arasında bağıntılı olduğunu bulmak ve bununla alakalı tahminler yürütmek. Sizler de aşağıdaki verisetini geliştirerek ve veriseti formatına getirerek bir csv dosyası oluşturup python kodlarınız için kullanabilirsiniz.
Veri önişleme ile alakalı yazımda elde ettiğimiz kodları tekrar aşağıda paylaşıyorum.
#Kütüphaneleri ekleme
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

#Verisetini ekleme
dataset = pd.read_csv('Data.csv')

#Son sütun hariç tüm sütunları alıp yeni bir obje dizisi oluşturma yani şehir, yaş ve maaş ile.
X = dataset.iloc[:, :-1].values

#Son sütunu bir obje dizisinin içine atama
y = dataset.iloc[:, 4].values

#Şehir sütunundaki kategorik verileri nümerik hale getirme
from sklearn.preprocessing import LabelEncoder
labelencoder_X = LabelEncoder()
labelencoded_sehir=labelencoder_X.fit_transform(X[:, 3])

# Veri setinin bağımsız değişken obje dizisini(yani X) ve bağımlı değişken obje dizisini (yani y) ayrı ayrı eğitim seti ve test seti olarak ikiye bölme

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.2, random_state = 0)

# Lineer regresyon denklemi
from sklearn.linear_model import LinearRegression
regressor = LinearRegression()
regressor.fit(X_train, y_train)

# Test sonuçlarını tahmin etme
y_pred = regressor.predict(X_test)
Çoklu lineer regresyonda bu kodu çalıştırmadan yapmamız gereken tek şey eliminasyon yöntemleriyle hangi değişkenlerin gerekli olup olmadığını ayırt ederek, sadece gerekli değişkenleri içeren bir veri seti oluşturmak.
Bu yazı biraz uzun oldu fakat en uzun konulardan birisiydi. Sabırla okuduğunuz için teşekkür ederim.
İyi çalışmalar dilerim, sağlıcakla kalınız :)
Abdullah Faruk ÇİFTLER