Veri Bilimi Notları 4: Özellik ölçeklendirme, normalizasyon, standartlaştırma
Veri setindeki değişkenleri karşılaştırılabilir hale getirmek: normalizasyon ve standartlaştırma, ne zaman hangisi.
İçindekiler
All the statistics in the world can not measure the brilliance of compassion.
Bu yazımda veri setleri üzerindeki özelliklerin ölçeklendirilmesi, bunu yapmak için normalizasyon ve standartlaştırma kullanımını anlatmaya çalışacağım. Açıkçası bu konu daha çok ileride göreceğimiz KNN (K-Nearest Neighbors) gibi uzaklığa (distance) dayalı makine öğrenmesi algoritmalarında yoğun olarak etkisini göstermekte. Şimdiden öğrenmekte ve aklımıza yerleşmesinde fayda var. Çünkü bu da veri önişleme ile alakalı bir konu. Eğer daha önceki yazılarımı okumadıysanız aşağıdaki linklerden okuyabilirsiniz:
- Veri Bilimi Notları 1, Makine öğrenmesine giriş
- Veri Bilimi Notları 2, Makine öğrenmesi ve Python
- Veri Bilimi Notları 3, Veri önişleme
Özellik Ölçeklendirme Ne İşe Yarar? Ne Durumlarda Kullanılır?
Özellik ölçeklendirme dediğimiz şey veri setindeki iki farklı özelliğin (değişkenin) değerlerini en doğru şekilde analiz edebilmemize olanak sağlayan bir yöntemdir. Peki ne durumlarda kullanılır ve ne şekilde yapılır? İşte şimdi bu soruların cevaplarını beraber arayalım.
Öncelikle özellik ölçeklendirmeyi anlayabilmek için kendimize bir problem belirleyelim. Problemimiz şöyle olsun. İki farklı insan var. Bu insanların birisinin geliri ayda 5000 Türk Lirası iken diğerinin geliri ayda 200000 Türk Lirası olsun. Bu insanların ikisi de her ay belirli miktarda maddi yardım için maaşlarının bir kısmını ayırıyorlar. Diyelim ki 5000 Türk Lirası maaşı olan şahıs 1500 Türk Lirasını yardıma ayırıyorken, 200000 Türk Lirası alan şahıs 10000 Türk Lirasını yardım için ayırıyor.
Normal bir gözle bakarsak 10000 Türk Lirası yardımda bulunan kişinin daha fazla yardım yaptığını görürüz. Fakat bunu oranladığımızda 5000 Türk Lirası alan kişinin oransal olarak kat kat fazla yardım yaptığı anlaşılacaktır. İşte özellik ölçeklendirme ile biz bu özelliklerin sayısal değerlerinin birbirine yakın olmasını sağlayıp aralarındaki değerleri karşılaştırmak yerine oranları karşılaştırır. 5000 Türk Lirası maaş alan kişinin daha yüksek bir orana sahip olduğunu anlarız. Özellik ölçeklendirmenin ne işe yaradığına örnek verdiğimize ve ne olduğunu anladığımıza göre bununla alakalı yöntemlere geçebiliriz.
Normalizasyon (Normalleştirme)
Normalleştirme dediğimiz yöntem değişkenlerin 0 ve 1 arasındaki değerlere atanmasıdır.
x ′ = ( x − x m i n ) / ( x m a x − x m i n )
Normalizasyon kodlarını veri önişleme işleminde yazdığımız kodlardan sonrasına ekleyebiliriz.
from sklearn.preprocessing import MinMaxScaler
mms = MinMaxScaler()
X_train_normed = mms.fit_transform(X_train) //Eğitim setine normalizasyon uygulamak
X_test_normed= mms.transform(X_test) //Test setine normalizasyon uygulamak
Standartlaştırma
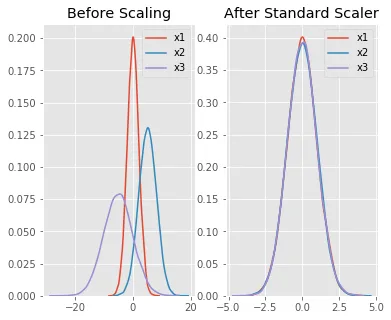
Değişken (özellik) sütunlarının ortalama değeri 0 ve standart sapması 1 olacak şekilde standart normal dağılım oluşturmaktır.
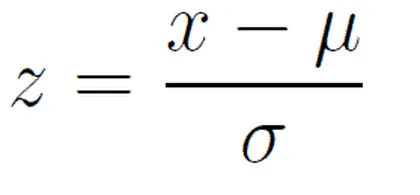
μ: ortalama, σ: standart sapma , x: değişken değeri
Yukarıda belirttiğim şekilde z puanlarını bulabiliriz. Ve artık değişkenler yerine z puanları sütunlarda yer alır. Bu sayede olasılıklar üzerinden daha rahat analizler yapabiliriz.
from sklearn.preprocessing import StandardScaler
stdsc = StandardScaler()
X_train_std = stdsc.fit_transform(X_train)//eğitim setinin standartlıştırılması
X_test_std = stdsc.transform(X_test)//test setinin standartlaştırılması
Sonuç
Eğer algoritmanızda standardizasyon veya normalizasyon yapmanız gerektiğinden şüpheniz varsa kesinlikle yapın. KNN, yapay sinir ağları gibi konularda algoritmanızın çok daha doğru eğitilmesini sağlayacaktır. İkisini birden yapmak manasızdır. İkisinden birisini yapmanız yeterli :=)
Bir sonraki yazımda regresyon’a giriş yapacağım ve artık makine öğrenmesine tam manasıyla başlayacağız. O zamana kadar görüşmek üzere.
İyi çalışmalar :)