Veri Bilimi Notları 3: Veri önişleme
Merhabalar. Bu yazıda veri önişleme nedir, ne tarz işlemler uygulanarak yapılır gibi sorulara cevap arayacağız. Şimdiden keyifli okumalar :)
Merhabalar. Bu yazıda veri önişleme nedir, ne tarz işlemler uygulanarak yapılır gibi sorulara cevap arayacağız. Şimdiden keyifli okumalar :)
Veri önişlemenin ne olduğundan bahsetmeden önce, kendisine neden ihtiyaç duyulduğundan bahsetmek isterim. Öncelikle bir ilk yazıda bahsettiğimiz veri setini kullanalım. Elimizde bir veri seti olduğunu düşünelim ve bu veri setinde aşağıda sıraladığım özellikler mevcut:
- Bazı satırlardaki verilerin eksik veya kaybolmuş olması. Örneğin bir ilçenin sıcaklık ve nem verilerini alt alta saniyelik satırlar olarak kaydeden bir sistemde bazı satırlarda sadece nem, bazı satırlarda sadece sıcaklık ve hatta bazı satırlarda ne sıcaklık ne nemin olmaması gibi., Anormalliği çok olan ve çok absürt şekilde ard arda gelmiş veriler var. Mesela 2, 3, 5, 6 şeklinde ilerleyen sayılardan sonra birden 140 veya 1400 gelmesi. Örneğin gerilimi sürekli ölçülen bir elektrik hattının normalde 220-240 arasında değişen voltaj değerinin saniyelik olarak 10000 civarında gözükmesi.
İşte yukarıda yazdığım ve buna benzer durumlar makine öğrenmesi algoritmasına zarar verecek durumlardır. Büyük ihtimalle ölçüm aletindeki veya metodundaki bir hatadan kaynaklanırlar. Bundan dolayı yazacağımız makine öğrenmesi yazılımını eğitirken bu verileri dikkate almamasını sağlamalıyız. Bu istenmeyen durumları veri önişleme yöntemiyle minimize ederek en doğru analizi yapabileceğiz. Veri önişleme aslında çok geniş bir konu olsa da şimdilik ben size kayıp verilerin yerlerinin doldurulması, kategorik niteliklerin nümerik hale getirilmesi, özellik ölçeklendirme gibi konularda tuttuğum notları aktaracağım. Yazıyı bir veri setini ilk yazıda bahsettiğim test seti ve eğitim setini anlatarak bitireceğim. İlerleyen süreçte gerektikçe eklemeler yapacağım.
Kayıp Verilerin Ortalama Değer ile Doldurulması
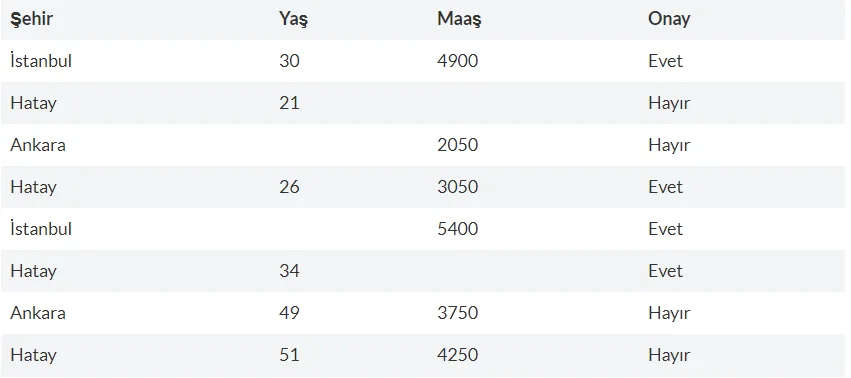
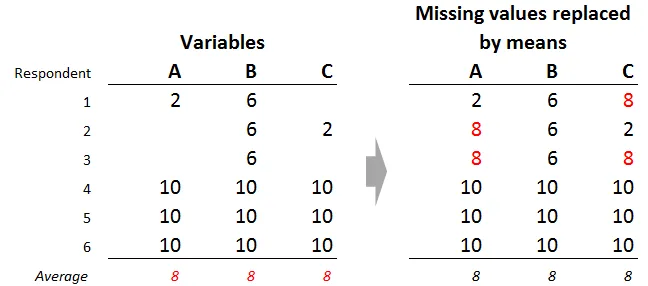
Yukarıdaki paragraflarda da bahsettiğim üzere bazı veri setlerinde ölçümdeki eksiklik, veri alma yöntemindeki çeşitli kusurlardan dolayı verilerin bir kısmının olmadığı görülebilir. Bu verilerin telafisi için ortalama değer ile doldurma ve en olası değerle doldurma gibi yöntemler vardır. Biz bu yazıda eksik verileri ortalama değer ile doldurma yöntemini göreceğiz. Bu yazıdaki tüm işlemler için örnek veriseti olarak “Data.csv” dosyasından çektiğimiz aşağıdaki tablodaki verileri kullanacağız. Aşağıdaki tabloya dikkatli bir şekilde baktığımızda bazı verilerin eksik olduğunu görmekteyiz.
Bütün bu işlemleri yapmadan önce bir önceki yazıda belirtildiği şekilde Data.csv dosyasını ve gerekli kütüphaneleri Python’a eklememiz gerekmekte. Aşağıdaki örnekte tekrardan ekledim.
#Kütüphaneleri ekleme
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

#Verisetini ekleme
dataset = pd.read_csv('Data.csv')

#Eksik verileri aynı değişkende yer alan tüm verilerin ortalamasına eşitleme
dataset["Yaş"].fillna(dataset["Yaş"].mean(), inplace=True)
dataset["Maaş"].fillna(dataset["Maaş"].mean(), inplace=True)

#Son sütun hariç tüm sütunları alıp yeni bir obje dizisi oluşturma yani şehir, yaş ve maaş ile.
X = dataset.iloc[:, :-1].values

#Son sütunu bir obje dizisinin içine atama
y = dataset.iloc[:, 3].values
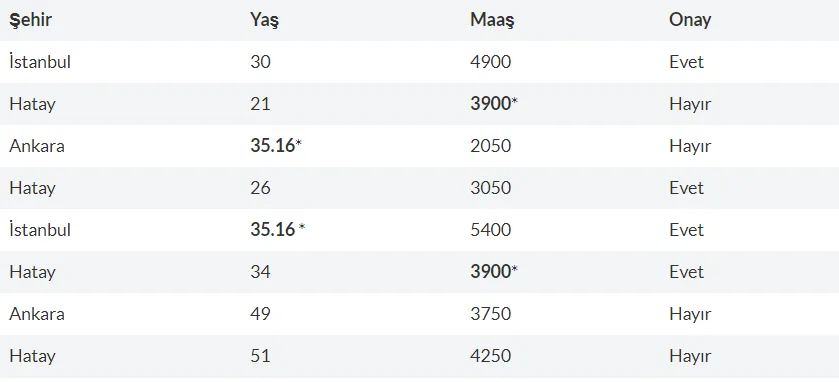
Bütün bu işlemleri yaptığımızda tablomuzdaki eksik verilerin yerini aşağıda olduğu gibi o sütunun ortalama değeri alacaktır.
.iloc: Sütunu indeksine göre bulur. Başka bir deyişle, ‘iloc’ kullanmak, yalnızca indekslerini alarak sütunları almamızı sağlar.
.values: Numpy dizisi içinde aldığınız sütunların değerlerini (indekslerine göre) döndürür. Temel olarak X ve y’nin Numpy dizileri haline gelmesi budur.
Kategorik Niteliklerin Nümerik Hale Getirilmesi
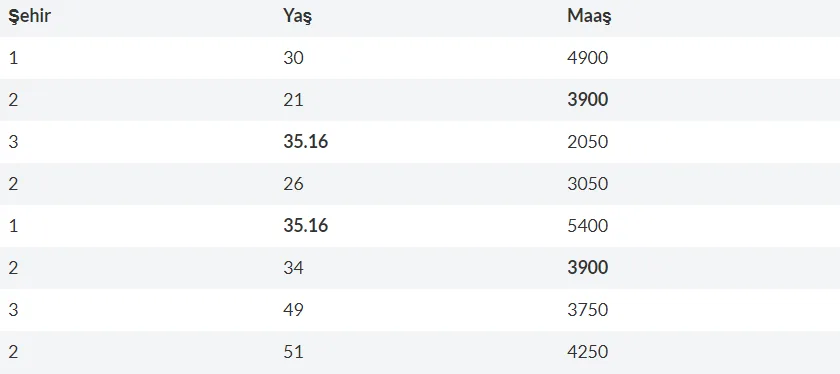
Kategorik verilerin nümerik hale getirilmesi, makine öğrenme algoritmasının çalışabilmesi için zorunlu bir durumdur. Çünkü bütün matematiksel işlemler nümerik değişkenler üzerinden yapılır. Bir önceki örnekte “Onay” sütunu hariç tüm sütunları X obje dizisine atamıştık. Yani X obje dizisinin içerisinde bir tek şehir kategorik veri olarak kalmış, diğerlerinin hepsi nümerikti. Yani biz X üzerinden bir analiz yapmak istersek bir tek şehir sütununu nümerik hale getirmeliyiz.
#Şehir sütunundaki kategorik verileri nümerik hale getirme
from sklearn.preprocessing import LabelEncoder
labelencoder_X = LabelEncoder()
labelencoded_sehir=labelencoder_X.fit_transform(X[:, 0])
Yukarıdaki kodu ana kodumuzun devamına eklediğimiz zaman aşağıdaki gibi bir obje dizisi elde edeceğiz. İstanbul’a nümerik değer olarak 1’in, Hatay’a 2’nin ve Ankara’ya 3’ün atandığını göreceğiz. Bu işlemin temel sebebini regresyon türlerine geçtiğimizde daha iyi anlayacağız.
Verisetini Eğitim Seti Ve Test Setine Bölmek
İlk yazımda yazdığım başlığı size hatırlatmak amacıyla tekrar buraya taşıyarak sizlere durumu açıkladıktan sonra nasıl yapıldığı hakkında bilgi vermeye çalışacağım.
Veri Setleri Neden Bölünür?
Veri setlerinin bölünme nedenini şöyle örnekleyebiliriz. Diyelim ki elimizde 12 aylık bir hava durumu verisi var. Ve biz bu verileri kullanarak hava durumu tahmin uygulaması yapmak ve gelecekteki hava durumlarını tahmin etmek istiyoruz. Makine öğrenmesi algoritmaları kendilerini eğitmek için veriye ihtiyaç duyar. Şöyle düşünebilirsiniz. Bir şehre dair kanaatleriniz memleketi o şehir olan daha önceden tanıdığınız kişilerle oluşur. Memleketi o şehir olan insanların az çok ne özelliklere sahip olduğunu bilirsiniz. İşte makine öğrenmesi uygulamaları da bizden o şehrin insanlarını kafasında bir şekle oturtmak için memleketi o şehir olan insan verilerini ister.
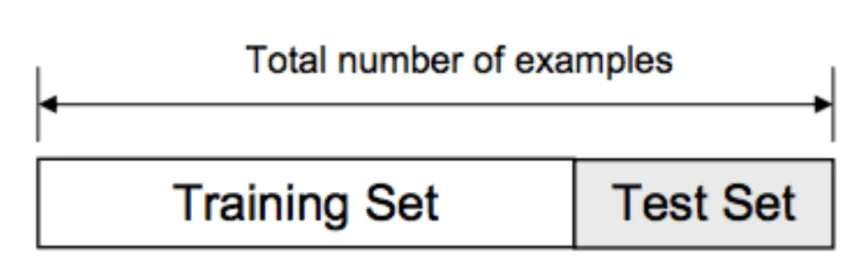
Fakat olay burada bitmiyor. Bizim elimizde sınırlı veri var ve algoritmamızın doğru çalışıp çalışmadığını test etmeliyiz. Diyelim ki tanıdığımız tüm Hataylı insanların verilerini algoritmamıza verdik. Bu sefer doğru çalışıp çalışmadığını test etmek için elimizde insan verisi kalmaz. Bundan dolayı verilerimizi ikiye ayırırız. Hataylı insanları tanıması için insan verilerimizin bir kısmını veririz. Lakin doğru çalışıp çalışmadığını test etmek için de verilerimizin kalan kısmını saklarız. Veri setleri genel olarak ikiye bölünür.
Eğitim Seti: Eğitim seti makine öğrenmesi algoritmasının eğitilmesi için verileri tanıması ve tahminlerini bu veriler üzerinden yapması için oluşturulan settir. Buna kısaca bundan sonraki verilere belli şekillerde önyargılı olmasını sağlayan veri seti diyebiliriz.
Test Seti: Eğitim seti kullanılarak oluşturulan algoritmanın ne derece doğru çalıştığını test etmek için daha önce kenara ayırdığımız veri setidir.
# Veri setinin bağımsız değişken obje dizisini(yani X) ve bağımlı değişken obje dizisini (yani y) ayrı ayrı eğitim seti ve test seti olarak ikiye bölme

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.2, random_state = 0)test_size: Burada eğitim seti ve test setinin oranının ne kadar olacağını ayarlarız. mesela bu örnekte her 10 veri için test setine 2 veri aktarırken eğitim setine 8 veri aktarır. Genel olarak test seti çoğu zaman 0.2 oranında olur. Çünkü modelin doğru eğitilmesi için veri fazlalığı önemlidir. Doğruluğu az veriyle de test edebiliriz ama modeli az veriyle eğitemeyiz.
Veri Önişleme Tüm Kodlar
#Kütüphaneleri ekleme
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

#Verisetini ekleme
dataset = pd.read_csv('Data.csv')

#Eksik verileri aynı değişkende yer alan tüm verilerin ortalamasına eşitleme
dataset["Yaş"].fillna(dataset["Yaş"].mean(), inplace=True)
dataset["Maaş"].fillna(dataset["Maaş"].mean(), inplace=True)

#Son sütun hariç tüm sütunları alıp yeni bir obje dizisi oluşturma yani şehir, yaş ve maaş ile.
X = dataset.iloc[:, :-1].values

#Son sütunu bir obje dizisinin içine atama
y = dataset.iloc[:, 3].values

#Şehir sütunundaki kategorik verileri nümerik hale getirme
from sklearn.preprocessing import LabelEncoder
labelencoder_X = LabelEncoder()
labelencoded_sehir=labelencoder_X.fit_transform(X[:, 0])

# Veri setinin bağımsız değişken obje dizisini(yani X) ve bağımlı değişken obje dizisini (yani y) ayrı ayrı eğitim seti ve test seti olarak ikiye bölme

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.2, random_state = 0)
Bir sonraki yazımda veri ölçeklendirme nedir, neden önemlidir gibi sorulara cevap arayacağım. Ondan sonra da regresyon türlerine geçiş yapacağız.
İyi çalışmalar :)
Abdullah Faruk ÇİFTLER